



Refinerías y Mantenimiento Industrial · Análisis tecnológico
Una instalación puede reunir miles de mediciones y seguir reaccionando tarde a sus fallas. La diferencia entre acumular datos y practicar mantenimiento predictivo aparece cuando alguien puede interpretar una señal, decidir qué hacer y demostrar que la intervención produjo un resultado.
La falla comienza antes de que el equipo se detenga
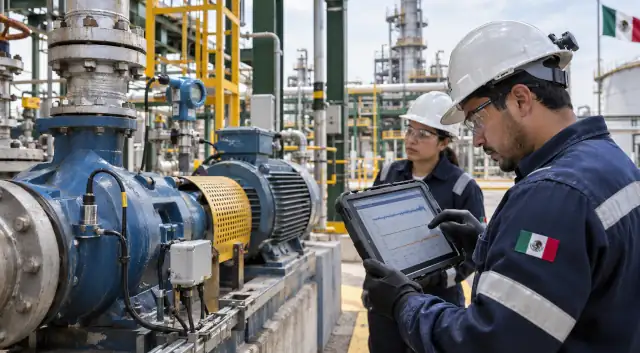
Imaginemos una bomba de transferencia en una instalación energética mexicana. El equipo continúa operando, conserva un caudal aceptable y no ha activado ninguna protección. Sin embargo, durante las últimas semanas su vibración aumentó gradualmente. También cambió la temperatura de un rodamiento.
El escenario es hipotético, pero plantea un problema real de ingeniería: dos variables presentan cambios, aunque todavía no existe evidencia suficiente para determinar si el origen es lubricación deficiente, desalineación, desgaste, una condición hidráulica o una variación normal del proceso.
Mantenimiento tiene varias alternativas. Puede continuar observando, solicitar una medición especializada, revisar las condiciones de operación o preparar una intervención. También podría actuar precipitadamente, desmontar un equipo sano y provocar una indisponibilidad innecesaria.
Esa incertidumbre es precisamente el campo de trabajo del mantenimiento predictivo. No se trata de adivinar la fecha exacta de una avería, sino de reconocer degradaciones relevantes con anticipación suficiente para tomar decisiones técnicamente justificadas.
En refinerías, terminales de almacenamiento, instalaciones petroquímicas, plantas de generación y servicios auxiliares, el desafío es semejante: proteger la función del activo, no solamente conservar sus componentes.
Qué es mantenimiento predictivo y qué lo distingue
El mantenimiento predictivo utiliza información sobre la condición y el comportamiento de un activo para estimar cómo puede evolucionar su degradación y decidir cuándo corresponde intervenir.
Es una estrategia dentro de la gestión de mantenimiento, no un producto informático independiente. Puede apoyarse en reglas estadísticas, modelos físicos, tendencias, inspecciones y algoritmos de aprendizaje automático. La inteligencia artificial es una posibilidad, no un requisito.
| Estrategia | Cuándo actúa | Decisión característica |
|---|---|---|
| Correctivo | Después de identificar una falla | Reparar o restablecer la función |
| Preventivo | Según tiempo, ciclos o uso | Ejecutar una tarea programada |
| Basado en condición | Cuando una medición indica deterioro | Inspeccionar o intervenir por condición observada |
| Predictivo | Ante una evolución de degradación estimada | Planear una intervención antes de perder la función |
| Prescriptivo | Cuando un análisis compara alternativas | Recomendar acciones bajo restricciones de riesgo, costo y operación |
Las estrategias pueden coexistir. Un equipo crítico puede conservar inspecciones reglamentarias, mantenimiento preventivo, monitoreo continuo y protecciones automáticas. Ninguna predicción sustituye por sí misma los controles de seguridad ni una obligación de inspección aplicable.
ISO 17359:2018 proporciona directrices generales para establecer programas de monitoreo de condición. Desde esta perspectiva, el punto de partida es comprender las máquinas y sus mecanismos de deterioro, antes de seleccionar instrumentos. [1]
No todos los activos merecen el mismo monitoreo
El primer error de muchos programas es comenzar comprando sensores para todos los equipos disponibles. La inversión se dispersa y el área de mantenimiento termina administrando señales de máquinas cuya falla tendría consecuencias limitadas.
La selección debería partir de una evaluación de criticidad que considere seguridad de las personas, impacto ambiental, pérdida de producción, redundancia, frecuencia y mecanismos de falla, costo de reparación y plazo de suministro de refacciones.
Una bomba relativamente pequeña puede ser prioritaria si representa un punto único de falla. En cambio, un motor de gran potencia podría tolerar una estrategia menos compleja cuando existe respaldo funcional y la intervención es sencilla.
La matriz activo, señal y decisión
| Activo | Degradación posible | Variable y técnica | Decisión y límite de confianza |
|---|---|---|---|
| Bombas centrífugas | Desalineación, rodamientos o inestabilidad hidráulica | Vibración, espectros, presión, caudal y temperatura | Revisar régimen y condición mecánica; vibración aislada no identifica la causa |
| Compresores | Desgaste, problemas de lubricación o inestabilidad | Vibración, presión, temperatura, aceite y parámetros de proceso | Evaluar diagnóstico y protecciones; una anomalía no equivale a falla confirmada |
| Motores eléctricos | Deterioro de aislamiento, rodamientos o desbalance | Corriente, temperatura, vibración y pruebas eléctricas | Programar pruebas especializadas; la carga puede alterar las señales |
| Turbinas | Alteraciones dinámicas o degradación de componentes | Vibración de eje, temperaturas, aceite y parámetros operativos | Comparar con límites y tendencias del fabricante; no reemplazar protecciones |
| Válvulas y actuadores | Fricción, desgaste, problemas de posicionamiento | Recorrido, tiempo de respuesta, presión y diagnóstico del actuador | Inspeccionar desempeño; una desviación no demuestra fuga interna |
| Intercambiadores de calor | Ensuciamiento o deterioro térmico | Presión diferencial, temperaturas, caudal y transferencia térmica | Evaluar limpieza; deben normalizarse carga y propiedades del fluido |
| Tuberías y equipos estáticos | Corrosión, erosión o pérdida de espesor | Ultrasonido, espesores, inspección y datos de proceso | Evaluar integridad con ingeniería; las tasas de deterioro son inciertas |
Matriz orientativa. La selección final depende del diseño, servicio, criticidad y requisitos específicos de cada instalación.
En bombas rotodinámicas, ANSI/HI 9.6.5-2022 aborda métodos de monitoreo de condición y variables como potencia, vibración, lubricación, presión y caudal. Es una referencia técnica para diseñar la vigilancia, no una garantía de diagnóstico automático. [2]
La identificación detallada de mecanismos hidráulicos, sellos y rodamientos corresponde al análisis de fallas en bombas industriales. Para requisitos de selección y seguridad funcional de componentes, también puede consultarse el estudio sobre válvulas críticas en refinerías. Aquí el centro es cómo convertir la información de esos activos en una estrategia de vigilancia operativa.
El sensor mide una variable; el diagnóstico exige contexto
Un acelerómetro registra movimiento vibratorio. Una sonda de temperatura registra condiciones térmicas. Un transmisor diferencial mide una diferencia de presión. Ninguno conoce por sí mismo la historia del equipo, sus cambios de carga ni los trabajos ejecutados.
La interpretación depende de comparar las mediciones con su condición operativa. Un incremento de vibración durante el arranque puede tener un significado distinto del mismo incremento a velocidad y carga estables. La temperatura de un rodamiento tampoco debe analizarse ignorando ambiente, lubricación y régimen.
La frecuencia de captura cambia lo que puede detectarse
No todas las variables necesitan la misma resolución temporal. Presiones y temperaturas de proceso pueden ser útiles con muestras relativamente espaciadas, dependiendo de la dinámica. El análisis de señales vibratorias de alta frecuencia requiere frecuencias de adquisición apropiadas para las componentes que se desean estudiar.
Registrar solamente un promedio de vibración cada varios minutos no permite reconstruir después un espectro de alta frecuencia. Tampoco almacenar miles de muestras por segundo garantiza un mejor análisis si se ignoran el montaje del sensor, la frecuencia de giro, el aliasing y la calibración.
La serie ISO 20816 proporciona criterios de evaluación de vibraciones para equipos comprendidos en sus respectivos alcances. En octubre de 2026 se publicaron las segundas ediciones ISO 20816-1:2026 e ISO 20816-3:2026. Sus criterios deben seleccionarse según la máquina y la medición; no son diagnósticos universales de rodamientos. [3] [4]
Una distinción que evita inversiones equivocadas
Medir: obtener una señal confiable. Detectar: identificar un comportamiento fuera de lo esperado. Diagnosticar: contrastar evidencia para determinar un mecanismo probable. Predecir: estimar cómo evolucionará una condición. Decidir: seleccionar una intervención con responsables y límites de riesgo.
Cada etapa puede requerir datos, herramientas y competencias diferentes. Una plataforma que entrega alertas no necesariamente realiza todas ellas.
Del SCADA a una orden de trabajo: el recorrido del dato
Una arquitectura de mantenimiento predictivo no termina cuando aparece un tablero con indicadores. El recorrido debe conectar equipos, sistemas de adquisición, datos históricos, análisis y procesos de mantenimiento.
Cadena operativa de información
Activo → sensor → adquisición → PLC/SCADA → historiador industrial → validación y contextualización → analítica → alerta → evaluación de ingeniería → CMMS/EAM → orden de trabajo → intervención → evidencia de resultado.
El PLC y el SCADA pueden proporcionar señales y contexto operativo. El historiador conserva tendencias. Una plataforma analítica procesa la información. El CMMS o EAM administra trabajos, recursos, intervenciones e historial de activos.
Para que exista trazabilidad, estos sistemas deben compartir identificadores consistentes. Si una señal utiliza el nombre de un motor, la orden de trabajo identifica otro código y el registro de reparación corresponde a un tercero, la evaluación posterior se vuelve poco confiable.
ISO 13374-1:2003 e ISO 13374-2:2007 ofrecen referencias para el procesamiento, la comunicación y la interoperabilidad de información de monitoreo de condición. Su utilidad está en estructurar el intercambio de datos, no en imponer una plataforma comercial particular. [5] [6]
Los errores de calidad que contaminan una predicción
Antes de entrenar modelos, una instalación necesita comprobar unidades, marcas de tiempo, sincronización, calibraciones, valores ausentes, cambios de instrumento y modificaciones de proceso.
Un sensor recalibrado puede producir un salto de señal que parece una anomalía. Una parada programada puede alterar las tendencias. Un cambio de producto puede modificar el régimen hidráulico sin que exista daño. Si estos eventos no se documentan, el modelo aprenderá relaciones equivocadas.
Por ello, los datos deben contextualizarse con velocidad, carga, temperatura de proceso, producto, turnos, mantenimientos y estados de operación pertinentes. También deben conservarse las versiones de modelos y los criterios utilizados para generar alertas.
Cuándo usar inteligencia artificial y cuándo basta una regla
El aprendizaje automático puede identificar patrones difíciles de representar mediante umbrales simples. Pero también puede fallar ante condiciones que no estuvieron presentes durante su entrenamiento.
Una regla fija resulta defendible cuando existe un límite de operación documentado. Una alarma estadística puede funcionar cuando se conoce la variabilidad normal. Un modelo físico sirve cuando las relaciones del sistema están suficientemente caracterizadas. La IA puede aportar valor cuando hay información representativa y un problema predictivo bien definido.
Predecir vida útil remanente exige todavía más: historiales de degradación, identificación de fallas, condiciones operativas comparables y una cuantificación de incertidumbre. Presentar una fecha exacta de falla sin estas evidencias crea falsa precisión.
Una alarma útil necesita tiempo para actuar
Supongamos que un modelo detecta una tendencia anormal dos días antes de la pérdida de función, pero la refacción requiere cuatro semanas. La alerta puede ser correcta y, sin embargo, resultar demasiado tardía para una intervención planificada.
La anticipación necesaria debe incluir confirmación diagnóstica, disponibilidad de personal, compra de materiales, preparación de permisos y ventana operativa. La predicción sólo adquiere valor cuando existe una respuesta factible.
Falsas alarmas y fallas no detectadas
El desempeño no se demuestra únicamente con porcentaje de aciertos. En activos industriales, las fallas relevantes pueden ser poco frecuentes; un algoritmo que clasifica casi todo como normal podría mostrar alta exactitud y aun omitir los eventos importantes.
Conviene medir precisión, sensibilidad, falsas alarmas por activo y periodo, anticipación útil y costo operativo de cada alerta. También deben evaluarse las fallas no detectadas y las predicciones emitidas sin suficiente anticipación.
La validación debe respetar el tiempo: entrenar con periodos anteriores y evaluar sobre periodos posteriores, sin filtrar información futura. Separar ventanas del mismo evento entre entrenamiento y prueba puede inflar artificialmente el desempeño.
Además, el sistema necesita seguimiento posterior al despliegue. Cambios de carga, equipos modificados y sensores sustituidos pueden producir deriva estadística y exigir una nueva validación.
Conectar tecnología nueva sin comprometer la operación
Incorporar sensores inalámbricos, gateways, análisis remoto y plataformas en la nube introduce nuevas dependencias de conectividad, mantenimiento y ciberseguridad.
La arquitectura debe distinguir claramente la observación del control. Un sistema destinado a analizar tendencias no necesita necesariamente capacidad para modificar consignas, intervenir enclavamientos o emitir comandos de proceso.
El diseño debe contemplar segmentación de redes OT/IT, gestión de identidades, accesos de proveedores, intercambio controlado de información, continuidad durante desconexiones y recuperación ante incidentes.
IEC 62443-2-1:2024 aborda programas de seguridad para propietarios y operadores de sistemas industriales, mientras IEC 62443-2-4:2023 considera capacidades de seguridad de proveedores de servicios de integración y mantenimiento. [7] [8]
La analítica predictiva no debe convertirse en una vía indirecta para modificar sistemas de control sin evaluación formal. Las funciones instrumentadas de seguridad y las protecciones existentes mantienen sus requisitos de ingeniería independientes.
México: dónde tiene sentido empezar y qué exige el entorno
En México, la misma tecnología puede enfrentar condiciones muy diferentes. Una refinería necesita vigilar equipos de proceso continuo; una terminal, sistemas de bombeo y transferencia; una central eléctrica, turbinas, motores y servicios auxiliares. La infraestructura envejecida o modificada puede agregar dificultades de integración, pero la edad por sí sola no demuestra que un activo esté deteriorado.
PEMEX, CFE y los operadores privados representan contextos potenciales de aplicación. Sin embargo, no debe confundirse la viabilidad técnica de estas soluciones con su adopción efectiva en una instalación específica.
No contamos aquí con una serie pública de resultados suficientemente comparable para atribuir a una refinería mexicana determinada un porcentaje de fallas evitadas, ahorro económico o retorno generado por un programa predictivo. Por ello, las evaluaciones económicas posteriores se presentan como hipótesis de trabajo, no como casos de éxito documentados.
Seguridad de procesos y normativa aplicable
La NOM-028-STPS-2012 establece elementos de administración de seguridad para procesos y equipos críticos que manejen sustancias químicas peligrosas, dentro de su ámbito de aplicación. Su publicación original fue modificada mediante acuerdo de 2014 y continúa identificada en el marco normativo de la STPS consultado. [9] [10]
La norma no convierte automáticamente la instalación de inteligencia artificial en una obligación legal. Lo pertinente es integrar las decisiones de mantenimiento con los procedimientos, controles y responsabilidades exigibles al proceso correspondiente.
Para actividades reguladas del sector hidrocarburos, también deben revisarse las disposiciones aplicables de ASEA, incluidos los instrumentos relacionados con seguridad industrial, seguridad operativa y sistemas de administración. La Agencia mantiene una relación pública de disposiciones y modificaciones que permite identificar el marco correspondiente a cada actividad. [11]
En cuanto a gestión de activos, ISO 55000:2024 establece principios y terminología, mientras ISO 55001:2024 define requisitos para un sistema de gestión de activos. Estos estándares orientan decisiones sobre desempeño, riesgos y costos de ciclo de vida; su exigibilidad debe distinguirse de las obligaciones mexicanas y de los compromisos contractuales. [12] [13]
La diferencia importa en compras. Una empresa puede solicitar cumplimiento de una especificación API, ISO o Hydraulic Institute para determinados equipos, pero debe identificar edición, alcance y criterio de aceptación, sin afirmar que todos los estándares internacionales son obligatorios para todas las plantas.
Cómo contratar tecnología sin comprar únicamente un tablero
El mercado ofrece sensores, sistemas de adquisición, plataformas de análisis, software de mantenimiento, integradores y especialistas de confiabilidad. Comparar proveedores por número de funciones o capacidad anunciada de IA rara vez basta.
Una contratación debería comenzar con un activo, un mecanismo de degradación, una decisión esperada y un criterio de evaluación. El proveedor necesita demostrar cómo su solución cubre esa cadena.
Documentos y pruebas que conviene solicitar
- Alcance técnico por activo y modo de falla detectable.
- Hojas de datos, instalación y calibración de sensores.
- Frecuencias de captura, calidad de señal y tratamiento de datos faltantes.
- Arquitectura OT/IT, accesos, propiedad y exportación de datos.
- Integración demostrable con historiador, SCADA y CMMS/EAM.
- Resultados de validación con falsos positivos y fallas omitidas.
- Procedimiento de atención, responsables y tiempos de respuesta.
- Costos de licencias, conectividad, soporte y mantenimiento a varios años.
- Pruebas de aceptación y condiciones de salida sin dependencia excesiva del proveedor.
También debe comprobarse quién responde por el diagnóstico. Una empresa que vende sensores puede no realizar análisis de confiabilidad, mientras un consultor especializado puede depender de terceros para integrar los equipos a la red industrial.
El directorio de medición, instrumentación y control de NEXERGIA Market permite explorar perfiles por especialidad. También existe una categoría de ingeniería, construcción y mantenimiento industrial. La presencia en un directorio no constituye certificación de desempeño para un proyecto particular.
Para entender el alcance de fabricantes, talleres, integradores y contratistas puede consultarse la investigación sobre proveedores para refinerías mexicanas. La contratación debe cerrar la brecha entre tecnología ofrecida y resultado verificable.
Cuánto puede valer evitar una falla: un ejemplo en pesos
El argumento económico del mantenimiento predictivo suele concentrarse en los paros evitados. Sin embargo, el valor depende de cuánto tiempo habría estado realmente detenido un proceso, qué producción habría podido entregar y qué alternativas estaban disponibles.
Tampoco deben ignorarse las inspecciones adicionales, falsas alarmas, licencias, calibraciones, integración tecnológica y trabajo del personal.
Escenario didáctico completamente hipotético
Consideremos una instalación energética ficticia que evalúa monitorear un conjunto de bombas críticas. Su historial muestra cuatro eventos de parada no programada al año, cada uno con duración media de diez horas. Para efectos del ejercicio, se supone que el programa consigue evitar dos eventos comparables durante un año.
Los importes siguientes son supuestos ilustrativos. No representan resultados de PEMEX, CFE ni de ninguna planta real.
| Concepto | Supuesto | Impacto anual |
|---|---|---|
| Paros evitados | 2 eventos de 10 horas | 20 horas recuperadas |
| Margen contributivo recuperable | $55,000 MXN por hora | +$1,100,000 MXN |
| Reparaciones urgentes evitadas | 2 × $90,000 MXN | +$180,000 MXN |
| Intervenciones planificadas adicionales | 2 × $35,000 MXN | −$70,000 MXN |
| Falsas alarmas investigadas | 6 × $10,000 MXN | −$60,000 MXN |
| Operación anual del programa | Licencias, sensores y servicios | −$330,000 MXN |
| Beneficio neto operativo anual | Antes de inversión inicial | $820,000 MXN |
Supongamos además una inversión inicial de $900,000 MXN para adquisición, instrumentación, integración y puesta en operación.
Recuperación simple: $900,000 / $820,000 = 1.10 años aproximadamente.
Beneficio acumulado neto en tres años: (3 × $820,000) − $900,000 = $1,560,000 MXN.
Bajo esos supuestos, el retorno simple acumulado sobre la inversión inicial sería aproximadamente 173 % en tres años. El cálculo no considera descuento de flujos, impuestos, inflación, degradación de resultados ni inversiones futuras.
Existe una condición fundamental: las dos fallas consideradas evitadas deben ser atribuibles al programa. No basta comparar un año con cuatro eventos y otro con dos; podrían haber cambiado carga, producción, mantenimiento, redundancia o condiciones del proceso.
Si sólo se evitara un evento y los demás costos supuestos permanecieran constantes, el beneficio sería sustancialmente menor. El caso de negocio debe incluir sensibilidad ante escenarios desfavorables y no solamente el resultado esperado.
También debe evitarse la doble contabilización: no corresponde sumar como conceptos independientes una pérdida de producción y un margen contributivo que ya representa el valor económico de esa misma producción.
Cuando la evaluación incluye consumo eléctrico, pueden utilizarse tarifas efectivas, mediciones de energía y perfiles de carga. El catálogo de NEXERGIA Data incluye información comercial de tarifas CFE que puede apoyar ciertos análisis de costos, pero no sustituye la telemetría de equipos ni permite demostrar por sí sola fallas evitadas.
Las decisiones relacionadas con ventanas de intervención y pérdidas por indisponibilidad también pueden contrastarse con el análisis de paros de planta, ruta crítica y costos operativos.
Cómo comprobar si el programa realmente funciona
Una instalación necesita una línea base anterior a la intervención y una metodología consistente para evaluar cambios. Sin ella, incluso un tablero repleto de indicadores puede producir conclusiones engañosas.
Entre las métricas relevantes están la disponibilidad operacional, las horas de parada no programada, el tiempo medio entre fallas (MTBF), el tiempo medio de reparación (MTTR), los costos de reparación, el desempeño de alertas y las horas de mantenimiento ejecutadas.
El MTBF debe calcularse sobre poblaciones y criterios de falla comparables. El MTTR necesita una definición consistente de inicio y fin del tiempo medido. La disponibilidad requiere distinguir tiempo programado, indisponibilidad y restricciones de producción.
Es útil separar indicadores del modelo de indicadores de negocio. Una predicción puede tener buen desempeño estadístico y generar escaso ahorro si el equipo dispone de redundancia o las alertas llegan cuando ya no existe margen para intervenir.
Igualmente, un programa puede generar valor sin identificar la fecha exacta de falla: detectar una degradación y convertir una reparación de emergencia en trabajo planificado puede mejorar la gestión operativa.
Una ruta práctica para iniciar sin sobredimensionar el proyecto
El despliegue más defendible comienza con un piloto acotado, criterios de aceptación explícitos y responsables de mantenimiento involucrados desde su diseño.
- Seleccionar activos: establecer criticidad, historial, redundancia y modos de falla que justifican vigilancia.
- Evaluar datos disponibles: revisar señales existentes, instrumentación, calidad, permisos y capacidad de integración.
- Definir hipótesis técnicas: especificar qué degradación se pretende reconocer y qué decisión habilitará cada señal.
- Implementar un piloto: comenzar con reglas, análisis de tendencias o modelos apropiados y mantener supervisión de ingeniería.
- Validar resultados: documentar anomalías, inspecciones, diagnósticos confirmados, falsas alarmas y oportunidades de intervención.
- Escalar selectivamente: ampliar el programa sólo cuando las métricas operativas, los riesgos y el costo total respalden la decisión.
El Departamento de Energía de Estados Unidos, en su guía sobre mantenimiento de sistemas de bombeo, distingue acciones preventivas, predictivas y pruebas periódicas de eficiencia. La recomendación técnica consiste en utilizar información de condición para programar reparaciones oportunas, no en sustituir todo el mantenimiento tradicional. [14]
El cierre de cada intervención es tan importante como la detección. Deben registrarse el diagnóstico, las piezas inspeccionadas, el trabajo ejecutado, las mediciones posteriores y cualquier condición que confirme o contradiga la alerta inicial. Sin esta retroalimentación, el sistema acumula datos, pero no aprende de sus decisiones.
Por qué fracasan proyectos técnicamente sofisticados
Una plataforma puede funcionar correctamente y aun así no transformar el mantenimiento. Entre los problemas se encuentran instrumentación deficiente, datos incompletos, ausencia de responsables, reglas que producen alertas excesivas, modelos entrenados sobre periodos no representativos y decisiones desconectadas del sistema de órdenes de trabajo.
Otro error consiste en tomar la ausencia de alarmas como prueba de confiabilidad. Una señal puede estar desconectada, descalibrada o fuera del rango requerido. La vigilancia del propio sistema de monitoreo forma parte de su mantenimiento.
También existe el riesgo contrario: convertir cada anomalía en una intervención. El costo acumulado de inspecciones innecesarias puede superar el valor generado, especialmente en activos de baja criticidad.
La dirección de operaciones necesita exigir resultados verificables, mientras ingeniería y mantenimiento deben conservar la autoridad técnica sobre las decisiones. Ningún algoritmo debería ocultar la incertidumbre de una predicción.
Preguntas frecuentes sobre mantenimiento predictivo
¿Qué sensores se utilizan en mantenimiento predictivo?
Depende del mecanismo de falla. Se utilizan acelerómetros, sensores de temperatura, transmisores de presión, medidores de caudal, instrumentos eléctricos y técnicas de análisis de lubricantes, ultrasonido o inspección de integridad.
¿Se necesita inteligencia artificial para implementarlo?
No. Las tendencias, los umbrales fundamentados y los modelos físicos pueden ser suficientes. El aprendizaje automático debe justificarse por una mejora demostrable frente a alternativas menos complejas.
¿Puede el mantenimiento predictivo evitar todos los paros?
No. Existen fallas súbitas, mecanismos difíciles de observar, incidentes externos y condiciones fuera de los datos disponibles. La estrategia debe integrarse con mantenimiento, protecciones y gestión de riesgos.
¿Cómo saber si un proveedor ofrece resultados reales?
Solicite evidencia por activo, resultados sobre periodos independientes, fallas detectadas y omitidas, falsas alarmas, anticipación de alertas e intervenciones verificadas. Los ahorros deben sustentarse en una línea base comparable.
¿Cuándo conviene invertir en mantenimiento predictivo?
Cuando un activo presenta consecuencias relevantes de falla, mecanismos de degradación observables, datos de calidad suficiente y capacidad operativa para responder antes de perder su función.
La decisión de mantenimiento vale más que la predicción
El mantenimiento predictivo puede mejorar la confiabilidad de instalaciones energéticas mexicanas, pero sus beneficios no aparecen automáticamente al instalar sensores o contratar inteligencia artificial.
El valor se construye cuando un activo crítico tiene mecanismos de degradación comprendidos, mediciones confiables, criterios de interpretación, responsables de decisión y capacidad para actuar.
Una alerta que nadie atiende no evita una falla. Una predicción que no puede validarse tampoco demuestra ahorro. En cambio, una anomalía correctamente interpretada, seguida de una intervención documentada y una comparación económica rigurosa, puede justificar una estrategia de mantenimiento más inteligente.
Para refinerías, generación eléctrica y otras instalaciones industriales, la pregunta inicial no debería ser cuánta inteligencia artificial contratar, sino qué fallas importa anticipar, qué datos permiten hacerlo y qué decisión operativa puede cambiar con esa información.
Esta investigación forma parte de la serie Refinerías y Mantenimiento Industrial, dedicada a examinar la confiabilidad de activos, la integridad de instalaciones, las decisiones de mantenimiento y la proveeduría técnica del sector energético mexicano.
Referencias
Fuentes técnicas, normativas y documentales utilizadas para sustentar el análisis. Las normas deben aplicarse conforme a sus textos completos, edición, alcance y condiciones de uso; sus páginas descriptivas no sustituyen los documentos normativos.
- ISO. ISO 17359:2018 — Condition monitoring and diagnostics of machines — General guidelines. Tercera edición, enero de 2018. Consultar documento .
- Hydraulic Institute / ANSI. ANSI/HI 9.6.5-2022 — Rotodynamic Pumps Guideline for Condition Monitoring. Edición 2022. Consultar ficha técnica .
- ISO. ISO 20816-1:2026 — Mechanical vibration — Measurement and evaluation of machine vibration — Part 1: General guidelines. Segunda edición, octubre de 2026. Consultar documento .
- ISO. ISO 20816-3:2026 — Mechanical vibration — Measurement and evaluation of machine vibration — Part 3: Industrial machines with operating speeds between 120 r/min and 30 000 r/min. Segunda edición, octubre de 2026. Consultar documento .
- ISO. ISO 13374-1:2003 — Condition monitoring and diagnostics of machines — Data processing, communication and presentation — Part 1: General guidelines. Marzo de 2003. Consultar documento .
- ISO. ISO 13374-2:2007 — Condition monitoring and diagnostics of machines — Data processing, communication and presentation — Part 2: Data processing. Julio de 2007. Consultar documento .
- International Electrotechnical Commission. IEC 62443-2-1:2024 — Security for industrial automation and control systems — Security program requirements for IACS asset owners. Edición 2024. Consultar publicación .
- International Electrotechnical Commission. IEC 62443-2-4:2023 — Security for industrial automation and control systems — Security program requirements for IACS service providers. Edición 2023. Consultar publicación .
- Secretaría del Trabajo y Previsión Social. NOM-028-STPS-2012 — Sistema para la administración del trabajo-Seguridad en los procesos y equipos críticos que manejen sustancias químicas peligrosas. Diario Oficial de la Federación, 6 de septiembre de 2012. Consultar norma .
- Secretaría del Trabajo y Previsión Social. Acuerdo de modificación a la NOM-028-STPS-2012. Diario Oficial de la Federación, 10 de septiembre de 2014. Marco normativo vigente consultado en el portal de STPS. Consultar modificación . Consultar listado de normas STPS .
- Agencia de Seguridad, Energía y Ambiente. Disposiciones Administrativas de Carácter General. Catálogo institucional publicado el 24 de febrero de 2026, con instrumentos y modificaciones aplicables a distintas actividades del sector hidrocarburos. Consultar disposiciones .
- ISO. ISO 55000:2024 — Asset management — Vocabulary, overview and principles. Segunda edición, julio de 2024. Consultar documento .
- ISO. ISO 55001:2024 — Asset management — Asset management system — Requirements. Segunda edición, julio de 2024. Consultar documento .
- U.S. Department of Energy. Maintain Pumping Systems Effectively. Energy Tips — Pumping Systems, Tip Sheet #5. Documento DOE/GO-102005-2159, septiembre de 2005. Consultar documento técnico .


Comentarios